Fișierul care trece de toate verificările
Procesele de securitate a fișierelor se bazează pe o presupunere rar contestată: un fișier are un singur tip. Detectorul îi atribuie un tip, iar politica îl direcționează. Fiecare motor din aval analizează apoi fișierul ca fiind de acel tip: anti-malware, sandbox și curățare.
Fișierele poliglote contrazic această presupunere. Un singur flux de octeți poate fi, în același timp, un fișier GIF perfect valid și o arhivă Java perfect validă. Același truc funcționează și în cazul unui fișier JPEG care este, de asemenea, o arhivă RAR, sau al unui fișier PDF care conține un fișier ZIP complet dincolo de sfârșitul său logic. Fiecare parte este conformă cu standardele în sine, astfel încât niciun analizor de format individual nu detectează vreo problemă.
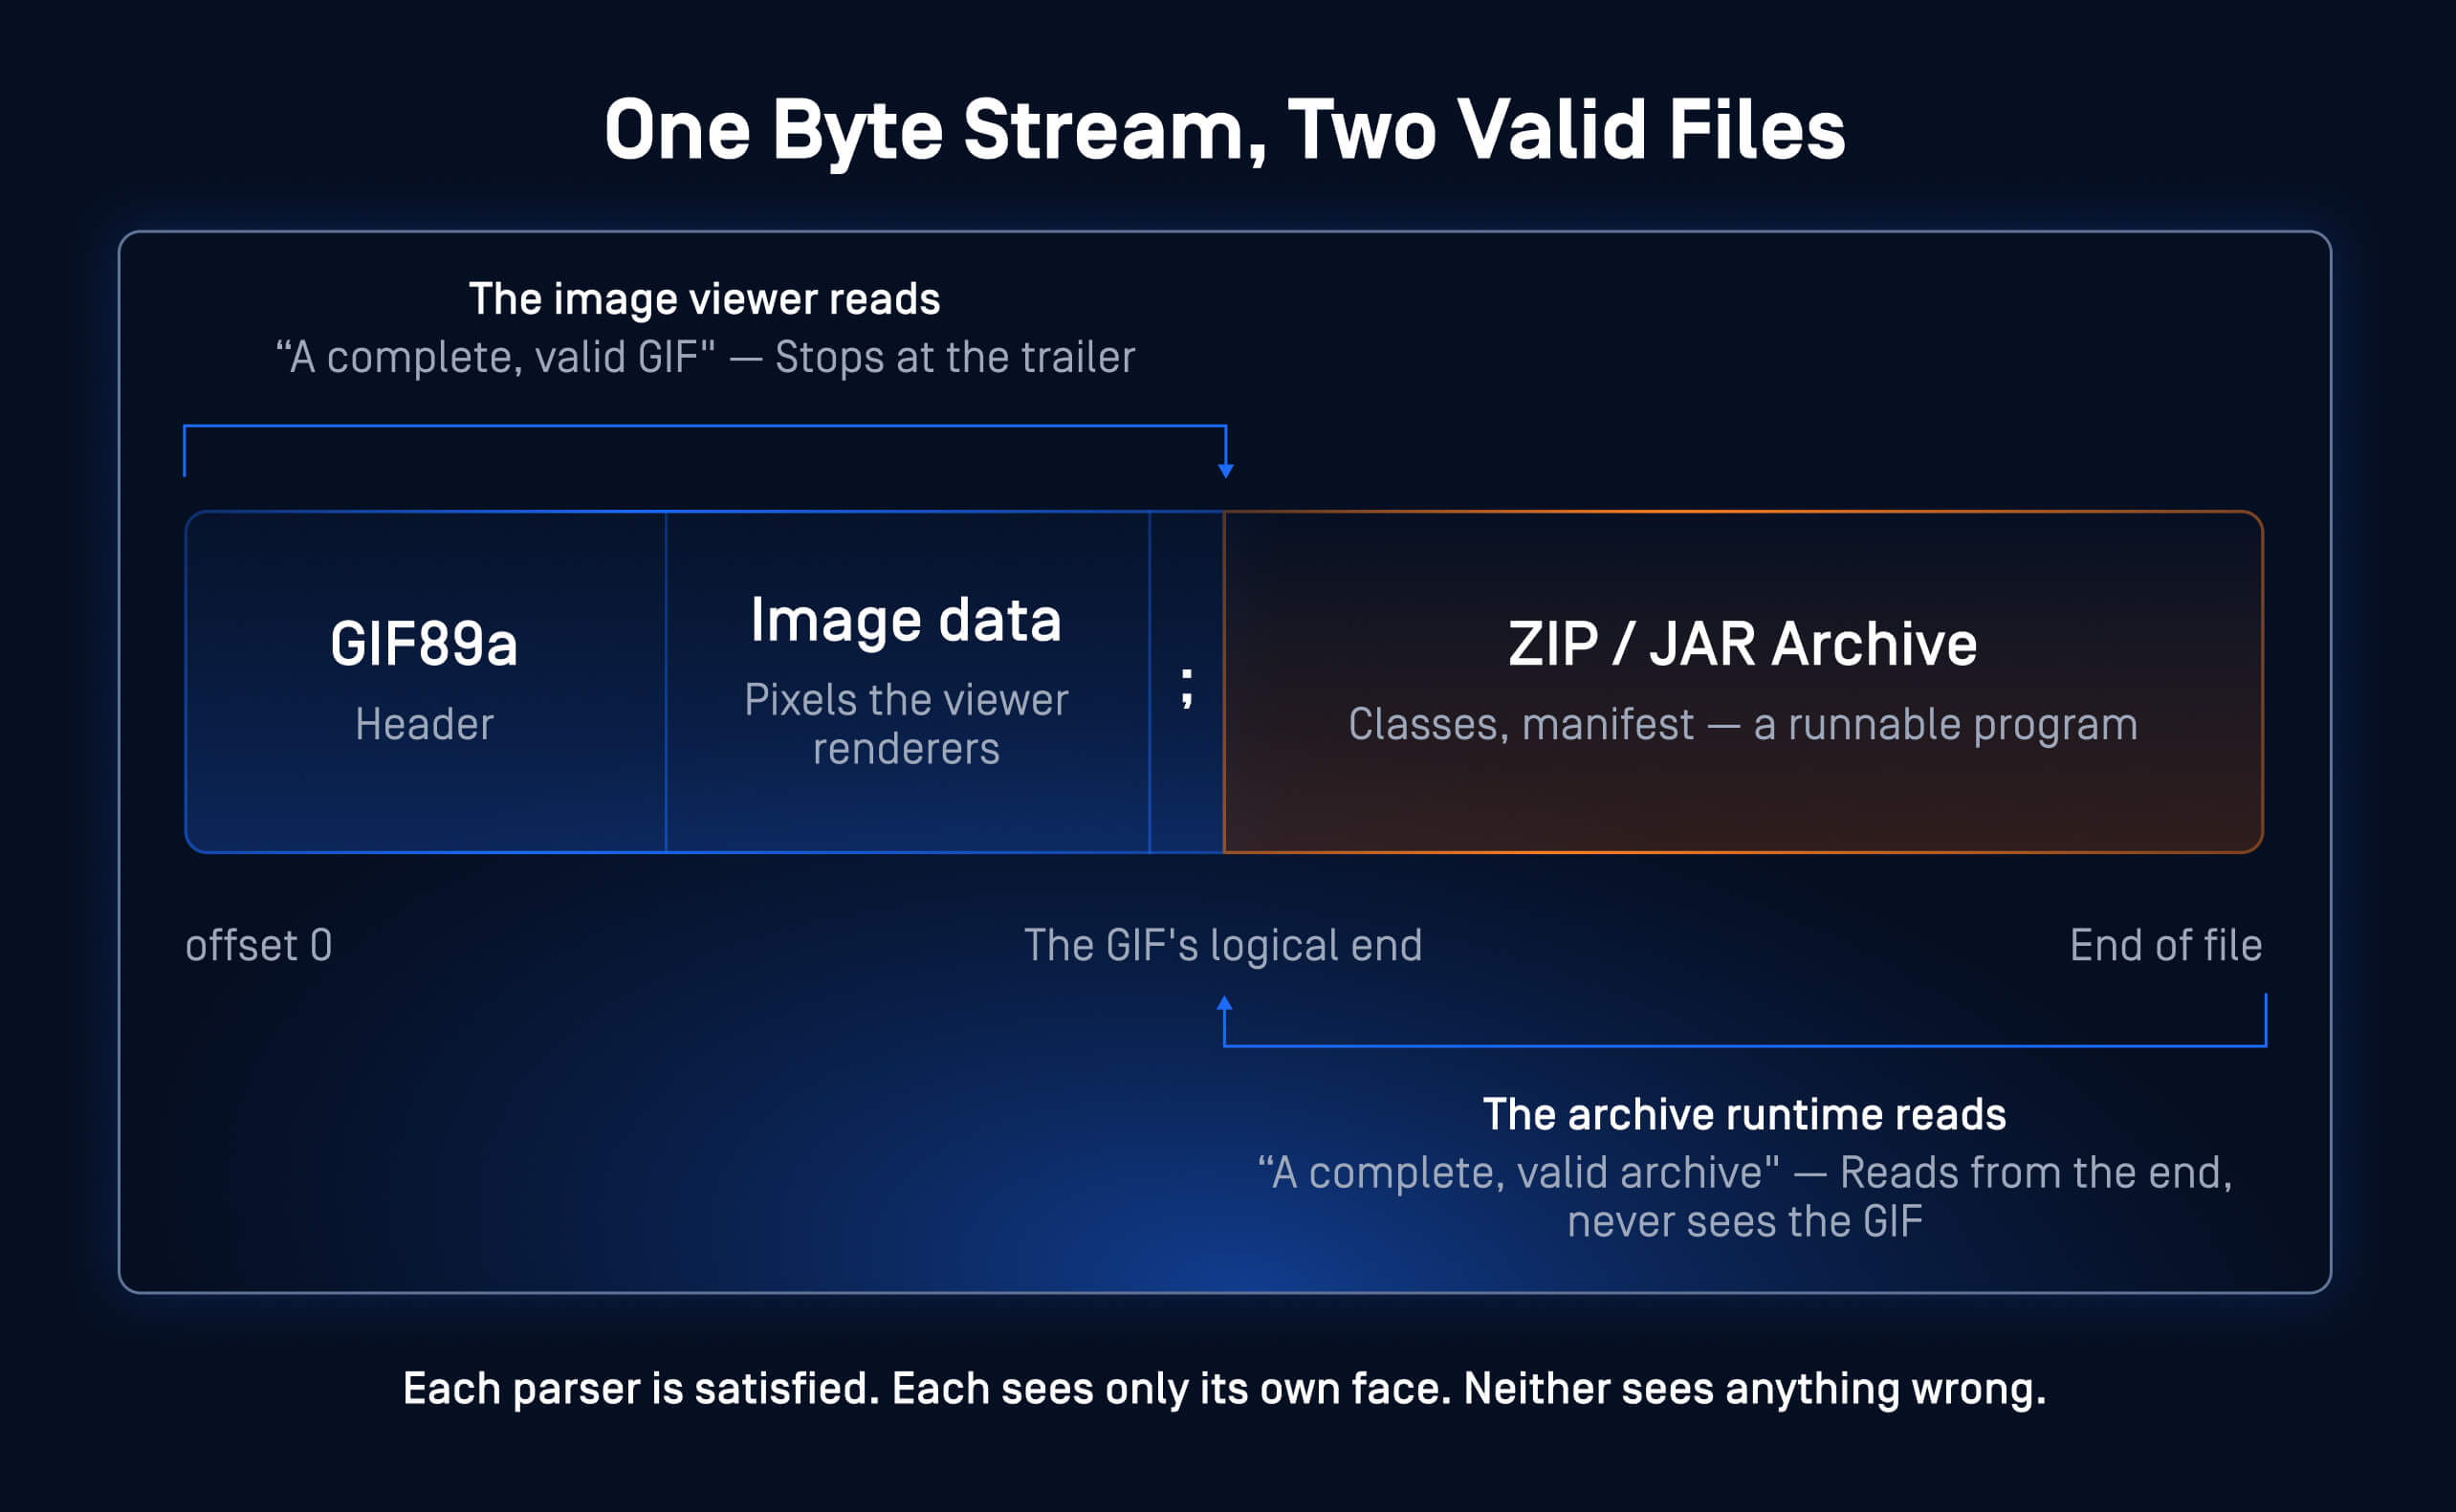
Un poliglot într-o singură imagine: clasicul GIF+JAR. Două analizatoare, două puncte de intrare, un singur fișier, iar fiecare variantă este perfect validă.
Consecința din punct de vedere al securității este clară: canalul de procesare scanează fișierul ca fiind de tipul pe care l-a detectat, iar celălalt format trece neatinse. O imagine care este, de asemenea, un script devine un atac XSS stocat atunci când o aplicație web o afișează. O arhivă ascunsă în spatele unei imagini își transportă încărcătura dincolo de filtrele de conținut. Lanțurile de atac construite pe această idee, de la combinația clasică GIF+JAR până la livrarea de exploatări asistată de steganografie, sunt cunoscute publicului de aproape două decenii. Motoarele anti-malware rămân în mare măsură orbite față de acestea, deoarece fiecare element, inspectat separat, este inofensiv.
Cum își găsește motorul o a doua față
Motorul nostru de validare a structurii fișierelor include detectarea poliglotă ca etapă de preprocesare care se aplică fiecărui fișier scanat, înainte de orice procesor de format. Proiectarea se bazează pe trei idei.
- Se scanează întregul flux. Scanerul verifică întregul fișier în raport cu o listă de semnături de format. Un al doilea format care apare oriunde în flux este identificat împreună cu offsetul său exact, chiar și atunci când fișierul are deja un tip detectat. Aceasta include semnăturile adăugate după marcatorul de sfârșit de fișier al unui PDF sau ascunse în spatele datelor de pixeli ale unei imagini.
- Aflați unde se termină în mod legitim un format. Formate precum Container pot conține în mod legal alte fișiere în interiorul lor. O imagine din interiorul unui fișier ZIP este un conținut obișnuit. Detectorul identifică sfârșitul real al fiecărui container pe baza structurii proprii a acestuia. Trailerul unui PDF, directorul central al unui ZIP și alocarea sectorilor unui fișier compus OLE (Object Linking and Embedding) marchează fiecare această limită. Analiza PDF-urilor ține cont de actualizările incrementale. Doar semnăturile din afara acelei structuri sunt considerate o a doua fațetă. Această limită structurală este cea care separă un verdict poliglot real de o alarmă falsă în cazul oricărei arhive obișnuite.
- Verificați înainte de a face acuzații. Motorul extrage fiecare față candidată din flux și o reidentifică în mod independent cu ajutorul motorului nostru de tipuri de fișiere înainte de a o raporta. Candidatele identificate ca date nestructurate sunt eliminate. Un verdict înseamnă că un al doilea format se analizează corect la acel offset. Ocazionalele octeți „magici” nu produc niciodată un astfel de verdict.
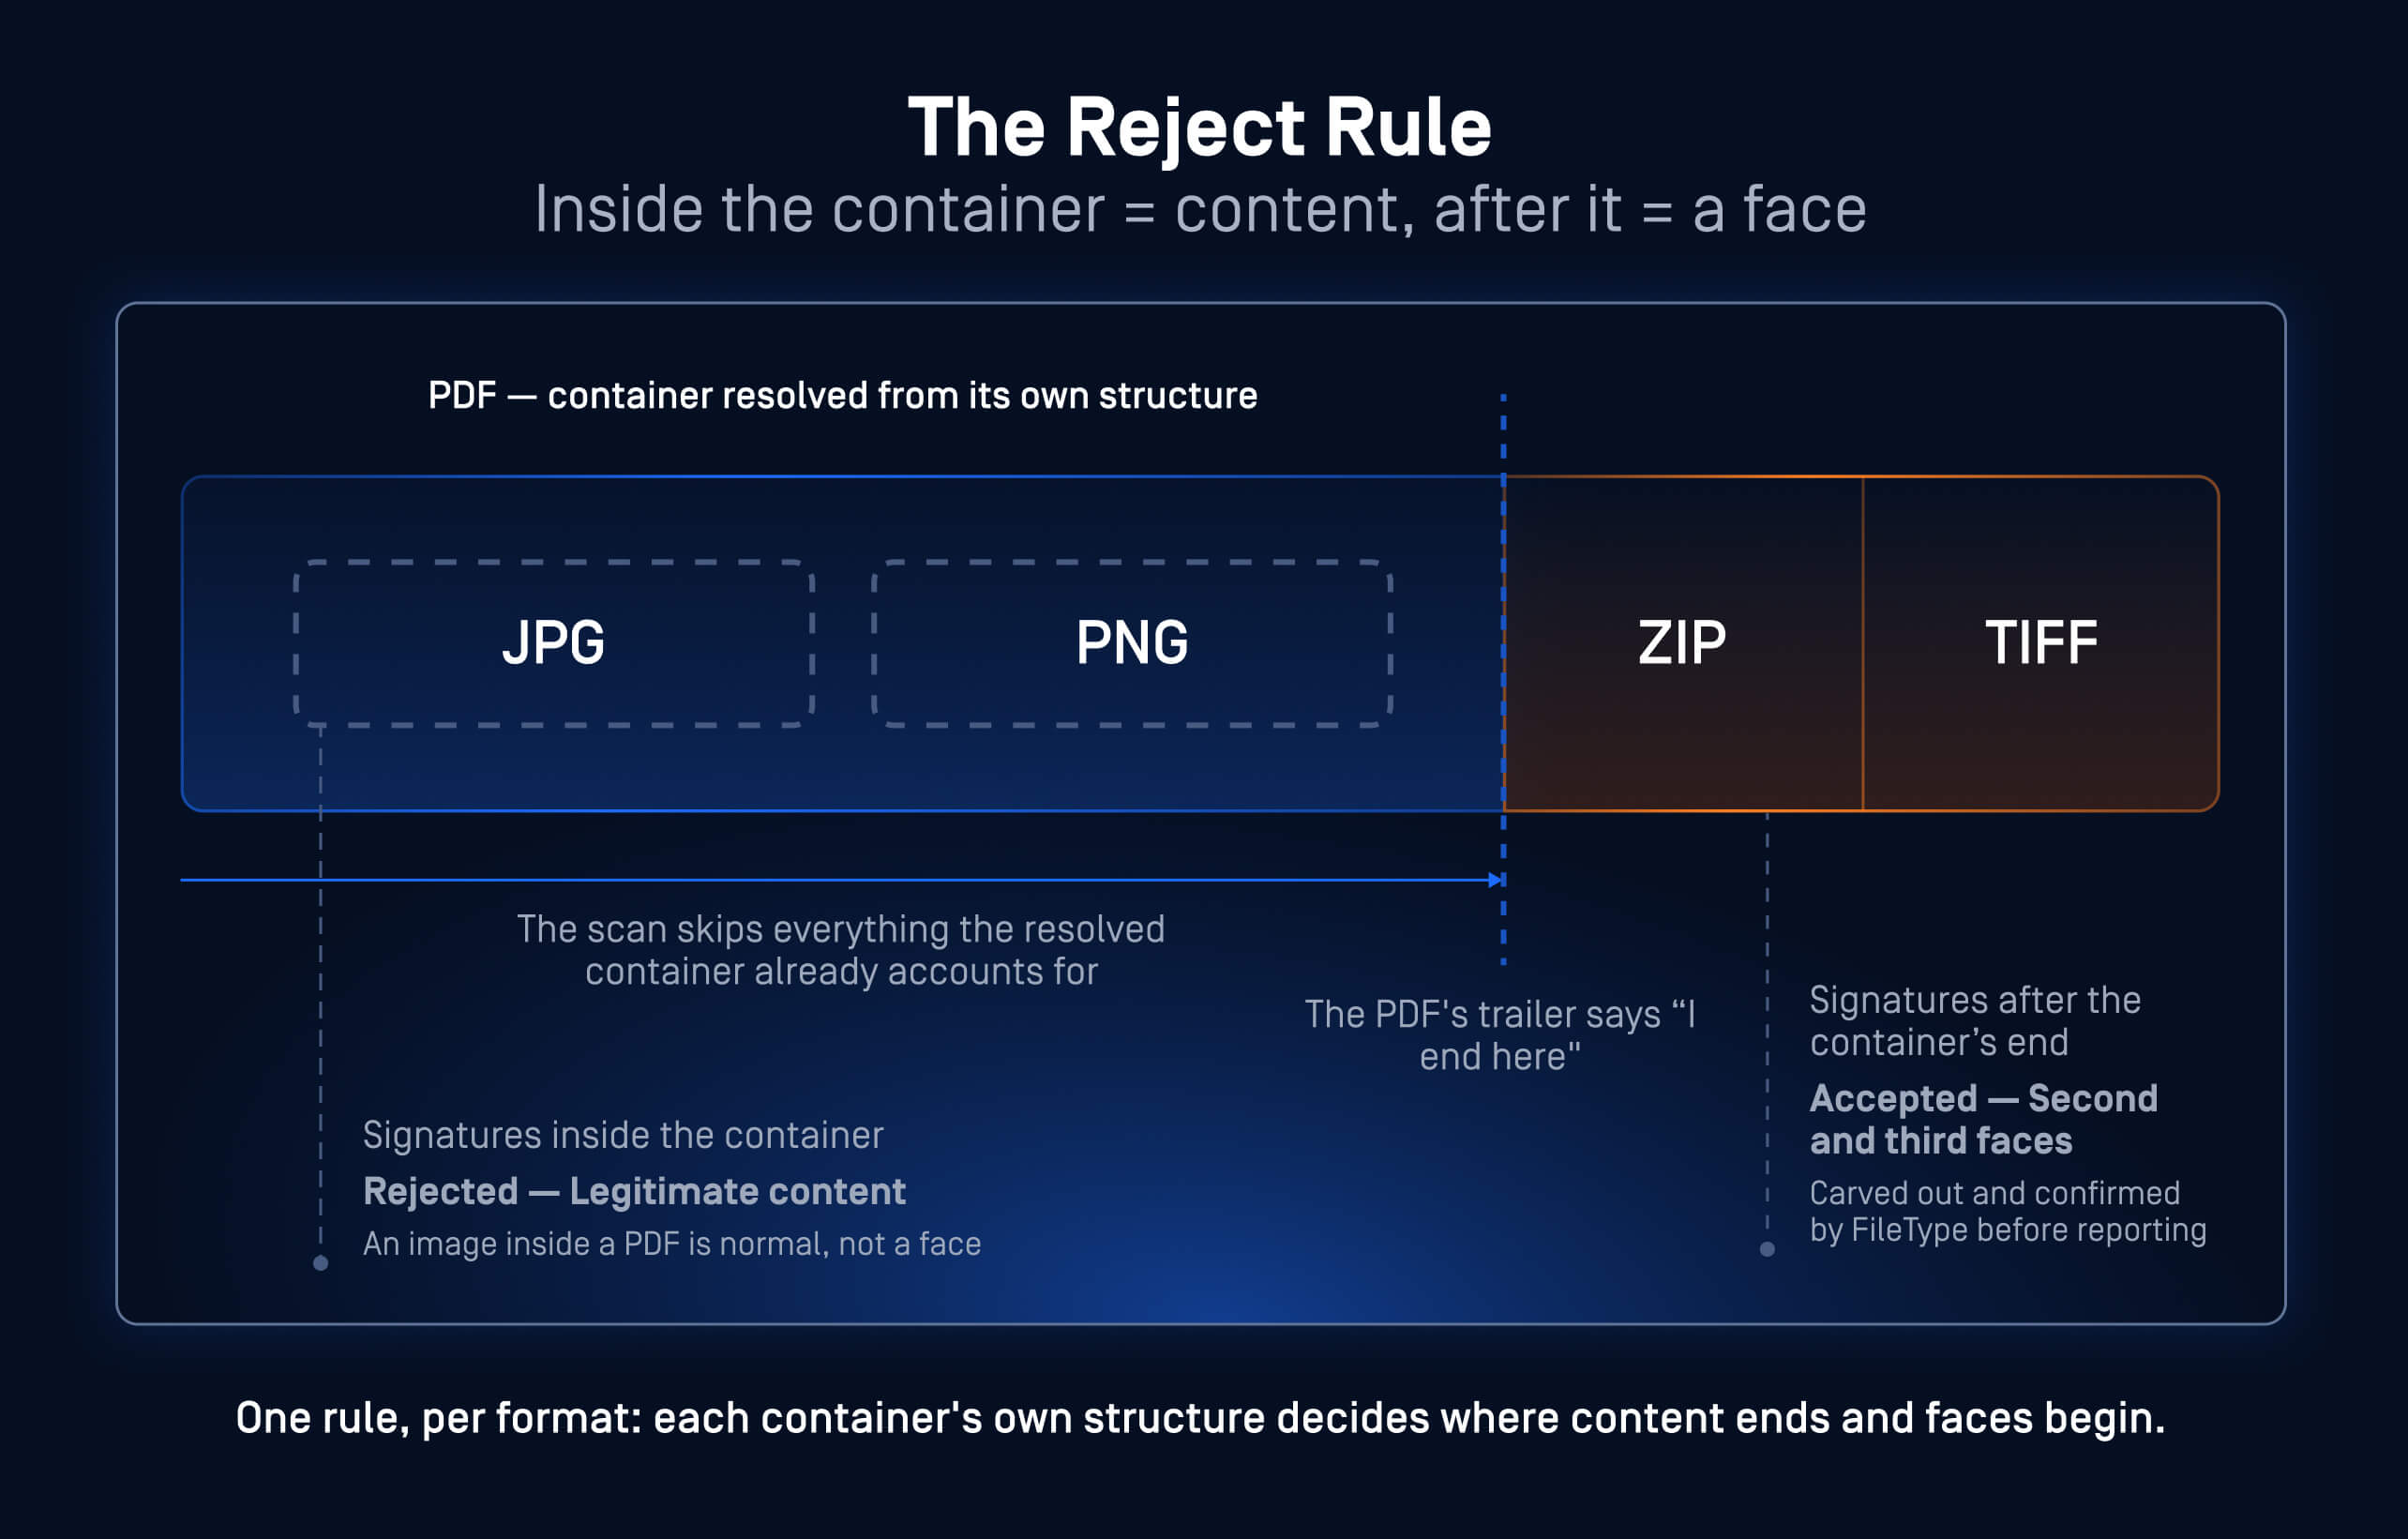
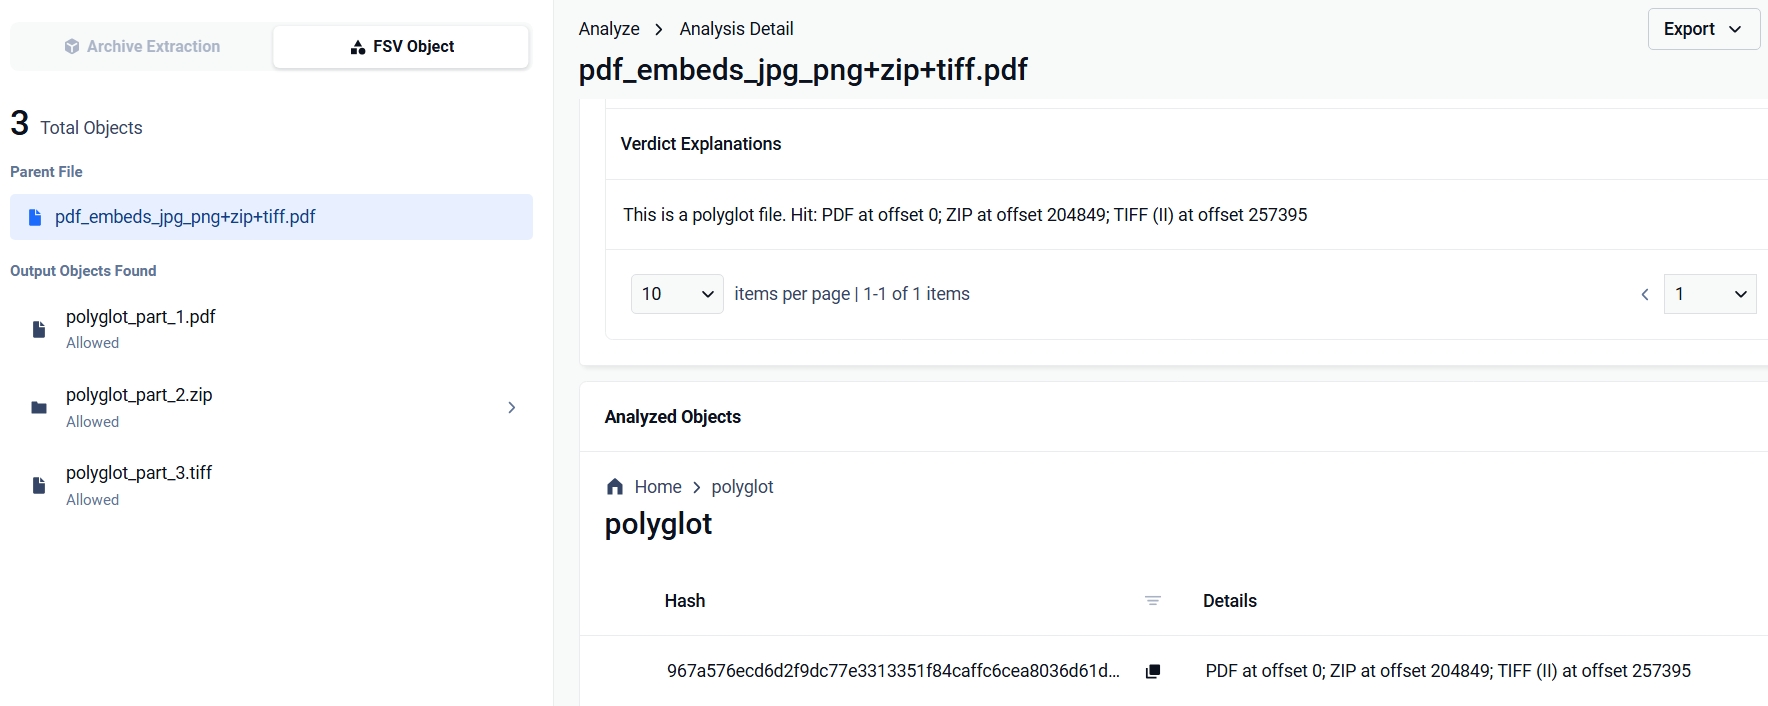
Extras dintr-un exemplu real: un fișier PDF care conține un fișier JPG și unul PNG, la care au fost adăugate, după sfârșitul său logic, un fișier ZIP și unul TIFF. Verdictul menționează fișierele ZIP și TIFF, dar nu face nicio referire la imaginile încorporate.
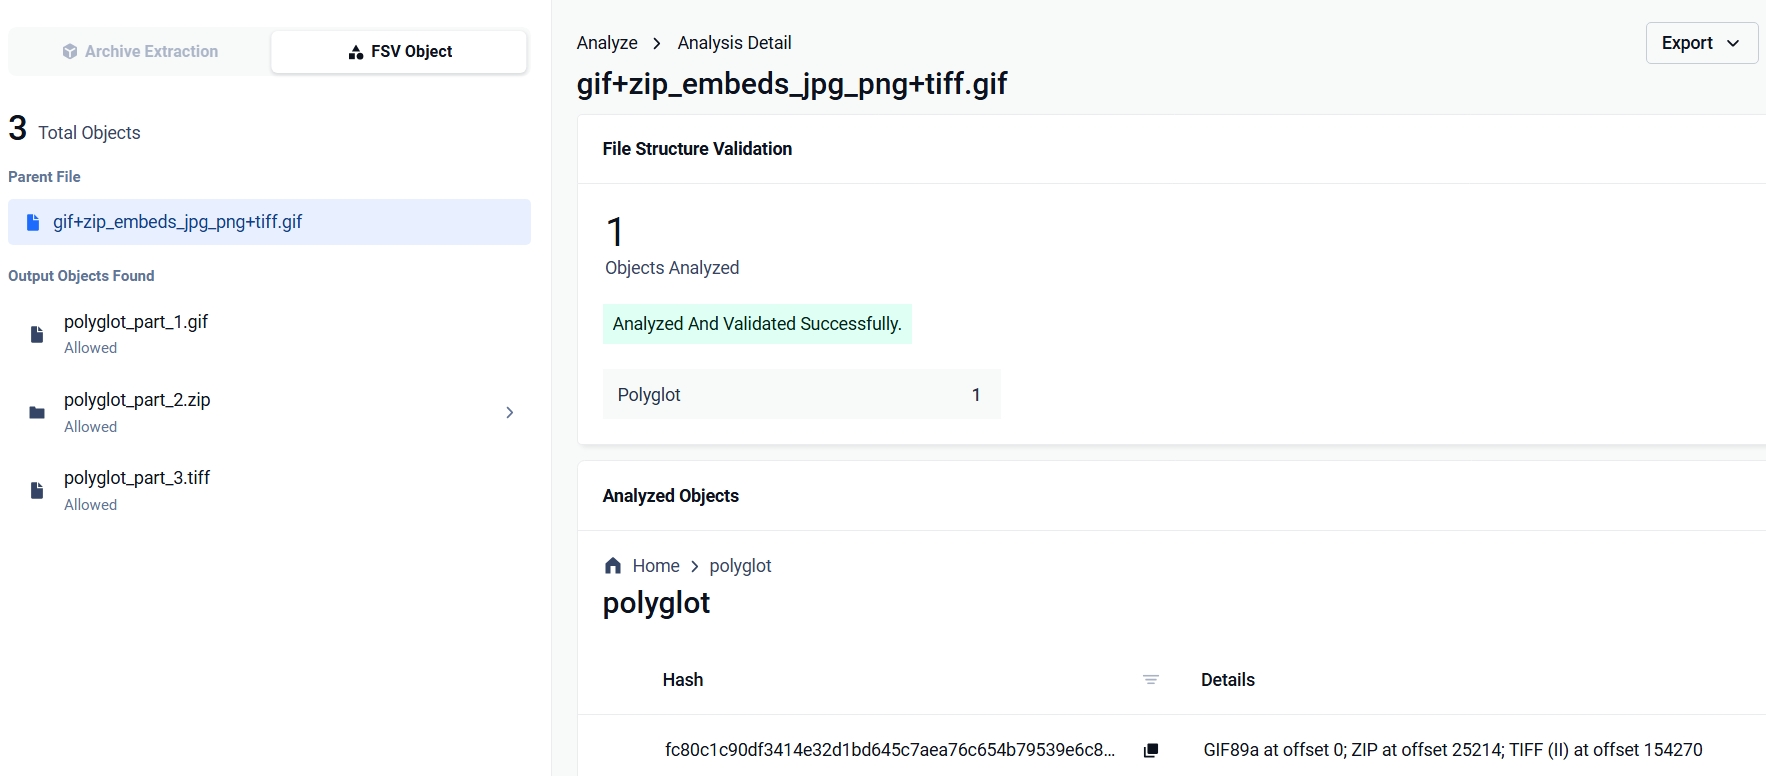
Rezultatul raportează fiecare față împreună cu offset-ul acesteia. Un singur fișier .gif încărcat, de exemplu, este identificat ca GIF89a la offset-ul 0 și ca arhivă ZIP mai adânc în flux. Politica decide restul: să raporteze descoperirea sau să blocheze fișierul direct, oferind o explicație care enumeră rezultatele pozitive.
De la detectare la disecție
Detectarea reprezintă doar jumătate din soluție, deoarece întregul „truc” al fișierului „polyglot” constă în faptul că fiecare față pare inofensivă în sine. După detectare, motorul analizează fișierul. Fiecare față confirmată este exportată ca obiect separat (polyglot_part_1.pdf, polyglot_part_2.zip și așa mai departe), împreună cu formatul, offsetul și dimensiunea sa. Motorul returnează fiecare dintre acestea către fluxul de lucru MetaDefender Core™ pentru procesare completă, în funcție de natura sa reală.
Am verificat acest lucru de la un capăt la altul pe o instanță activă de MetaDefender Core™.
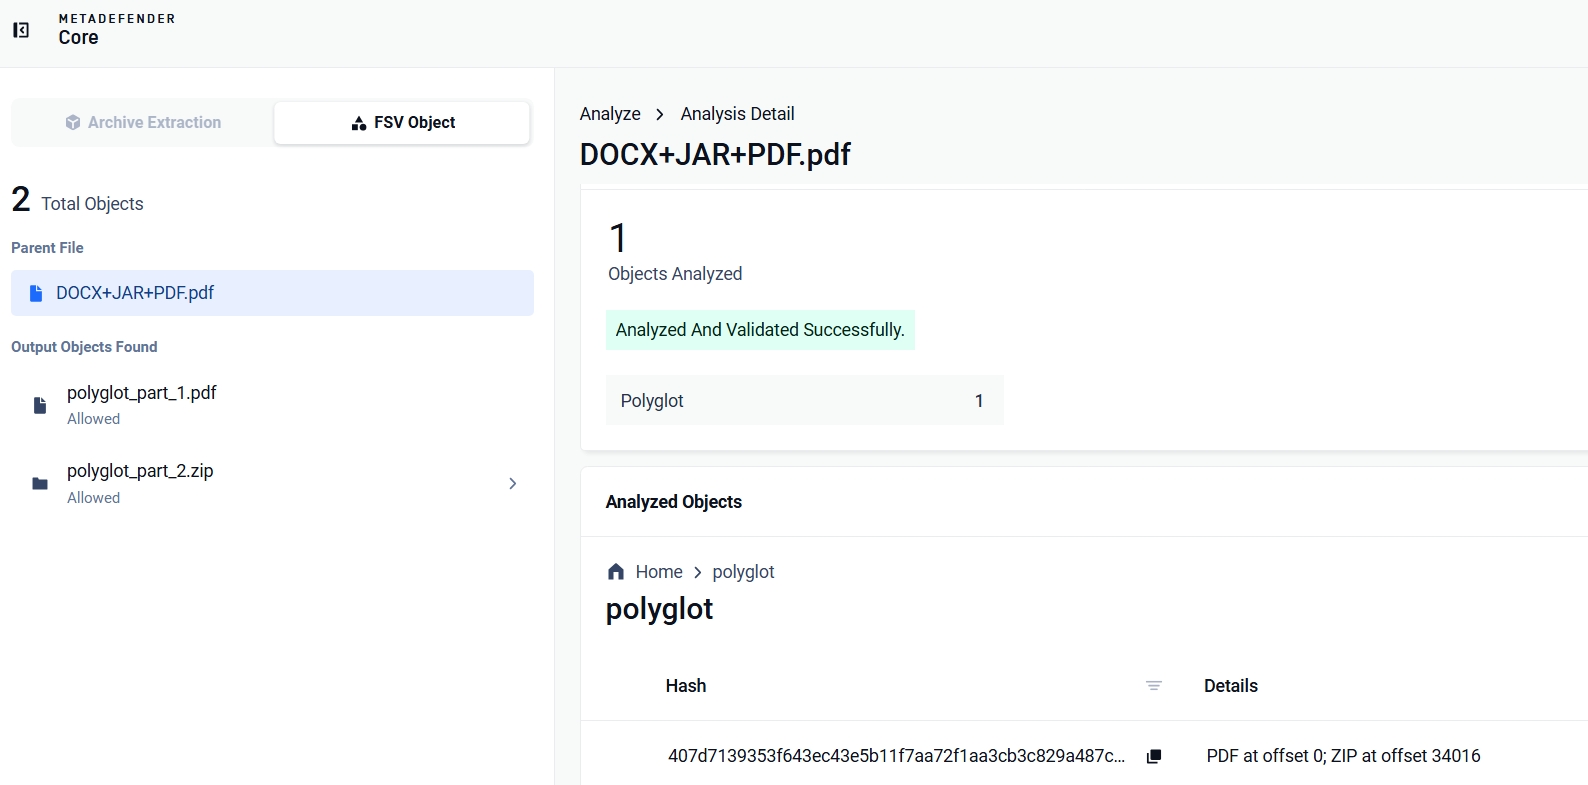
Motorul a separat un fișier PDF de probă care conținea în secret un document Word (un fișier poliglot de tip PDF+JAR+DOCX) în partea sa PDF și în partea sa ZIP. Deoarece atât JAR, cât și DOCX sunt containere ZIP, o singură parte ZIP îndeplinește ambele specificații. Motorul de tipuri de fișiere a identificat apoi acea parte ca fiind un DOCX, iar tehnologia Deep CDR™ a curățat-o individual. Partea ascunsă primește același tratament pe care a fost concepută să îl evite.
Precizia este partea cea mai dificilă
Byte-urile „magice” apar în mod natural în fișiere inofensive, așa că adevărata investiție tehnică constă în a nu da alarmă degeaba. Fotografiile realizate cu aparatul foto conțin miniaturi EXIF care au propria semnătură JPEG. Documentele Office încorporează imagini în structura lor de conținut. Fișierele de tip „ Media ” conțin în mod aleatoriu secvențe de octeți care seamănă cu anteturi de compresie. Logica de detectare exclude octeții care sunt deja luați în calcul de o structură legitimă, iar această consolidare este extinsă continuu, format cu format. Un detector care semnalează fiecare fotografie făcută cu aparatul foto este dezactivat, iar un detector dezactivat nu protejează pe nimeni.
Testat pe poligloți adevărați
Am testat eșantioane poliglot reale într-un mediu de implementare live MetaDefender Core™, folosind motorul de validare a structurii fișierelor. Toate au fost detectate, fiecare fiind identificată cu precizie la nivel de offset de octet:
Exemplu | Fețe găsite (decalaj) | Rezultat |
PDF care conține un document Word (PDF+JAR+DOCX într-un singur fișier) | PDF @ 0 · ZIP @ 34.016 | Fețele au fost extrase; fișierul DOCX ascuns a fost curățat cu ajutorul tehnologiei Deep CDR™ |
GIF care ascunde o arhivă și o a doua imagine | GIF89a @ 0 · ZIP @ 25.214 · TIFF @ 154.270 | Detectat |
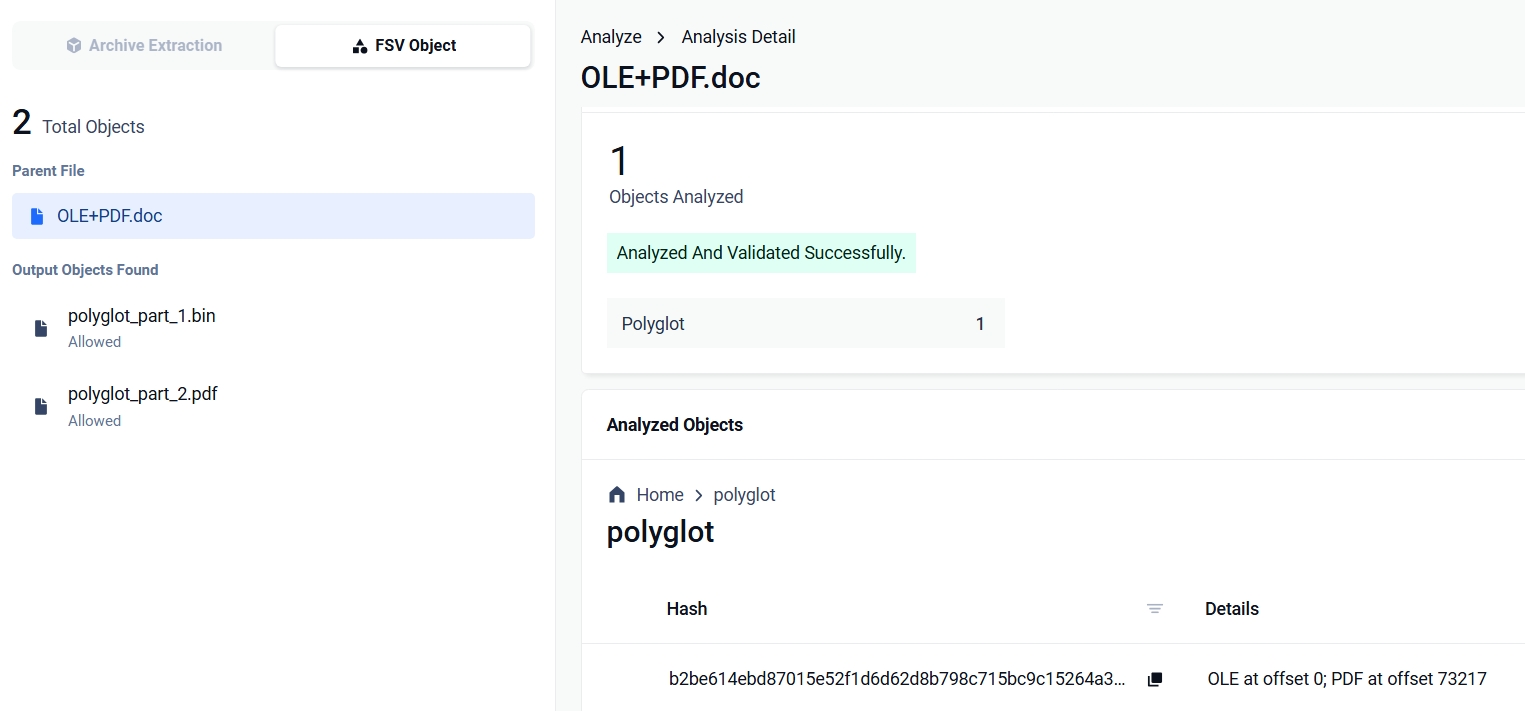
Document Office care ascunde un fișier PDF | OLE @ 0 · PDF @ 73.217 | Detectat |
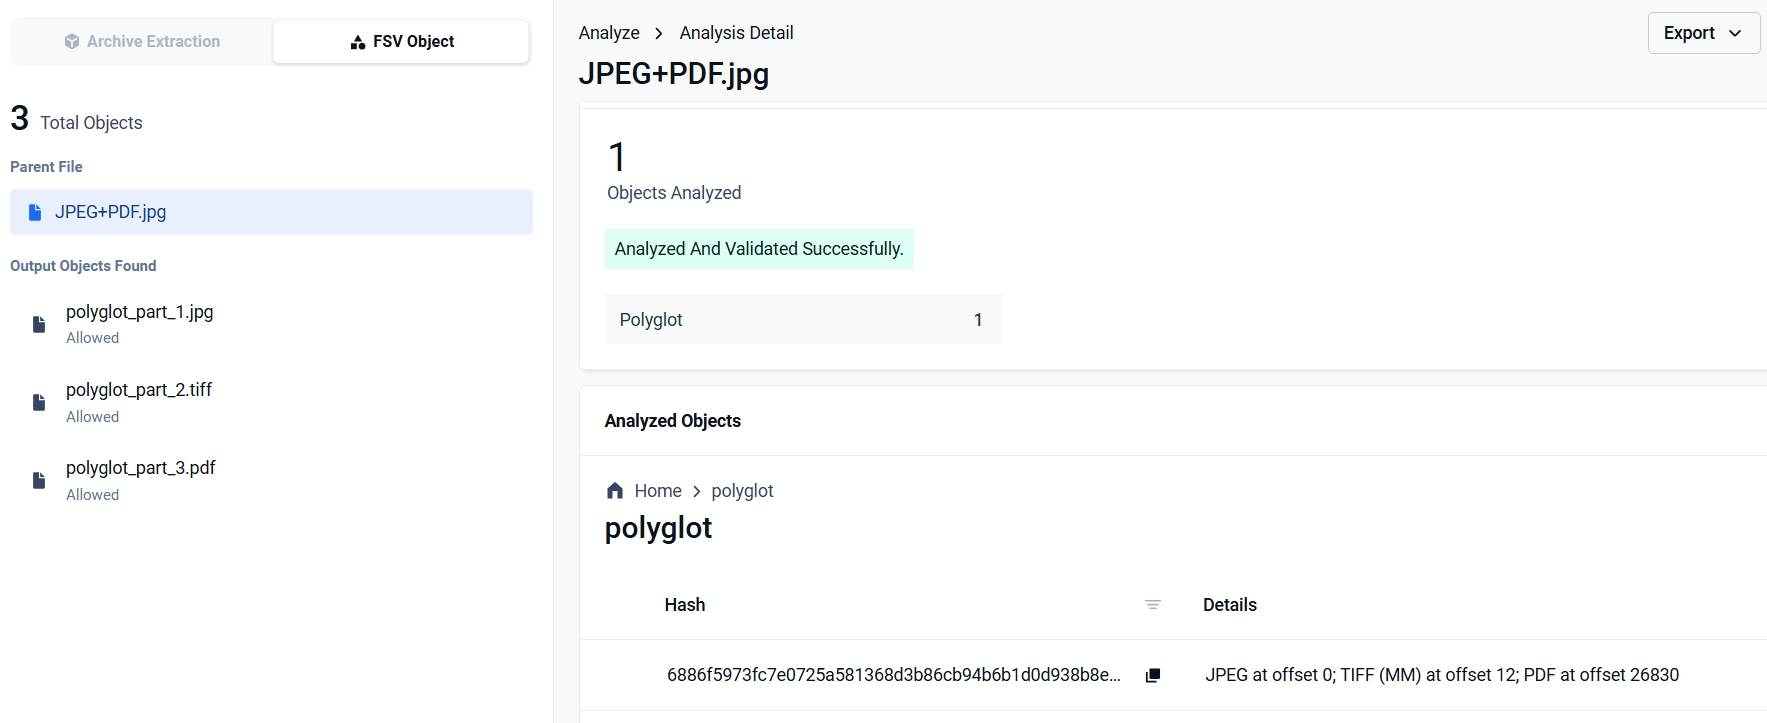
JPEG care ascunde un fișier PDF | Trei fețe, fișier PDF atașat @ 26.830 | Detectat |
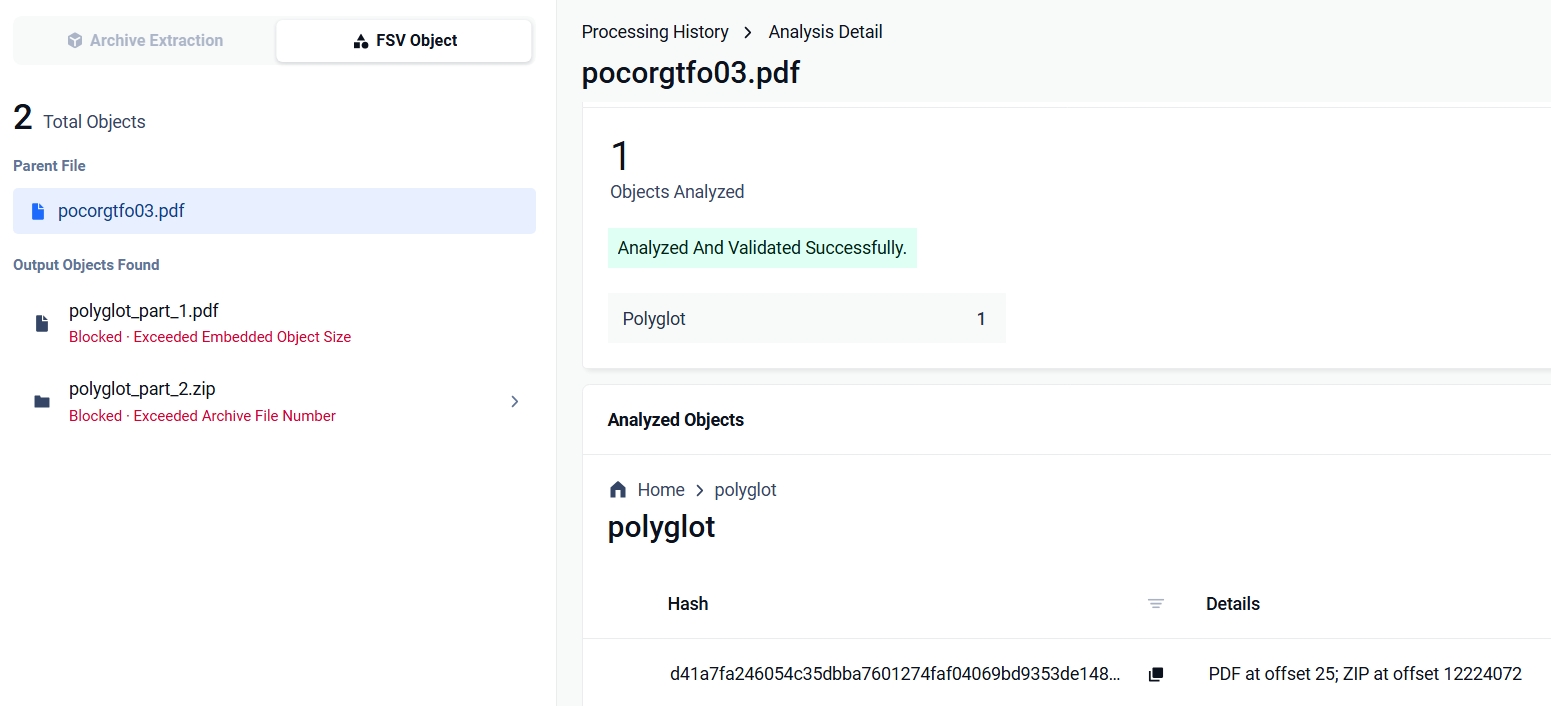
„PoC‖GTFO”, numărul 3, revista dedicată cercetării în domeniul securității, disponibilă în format PDF+ZIP în mai multe limbi, 26 MB | PDF @ 25 · ZIP @ 12.224.072 | Detectat: a doua față a fost găsită la o adâncime de 12 MB în urma unei scanări complete |
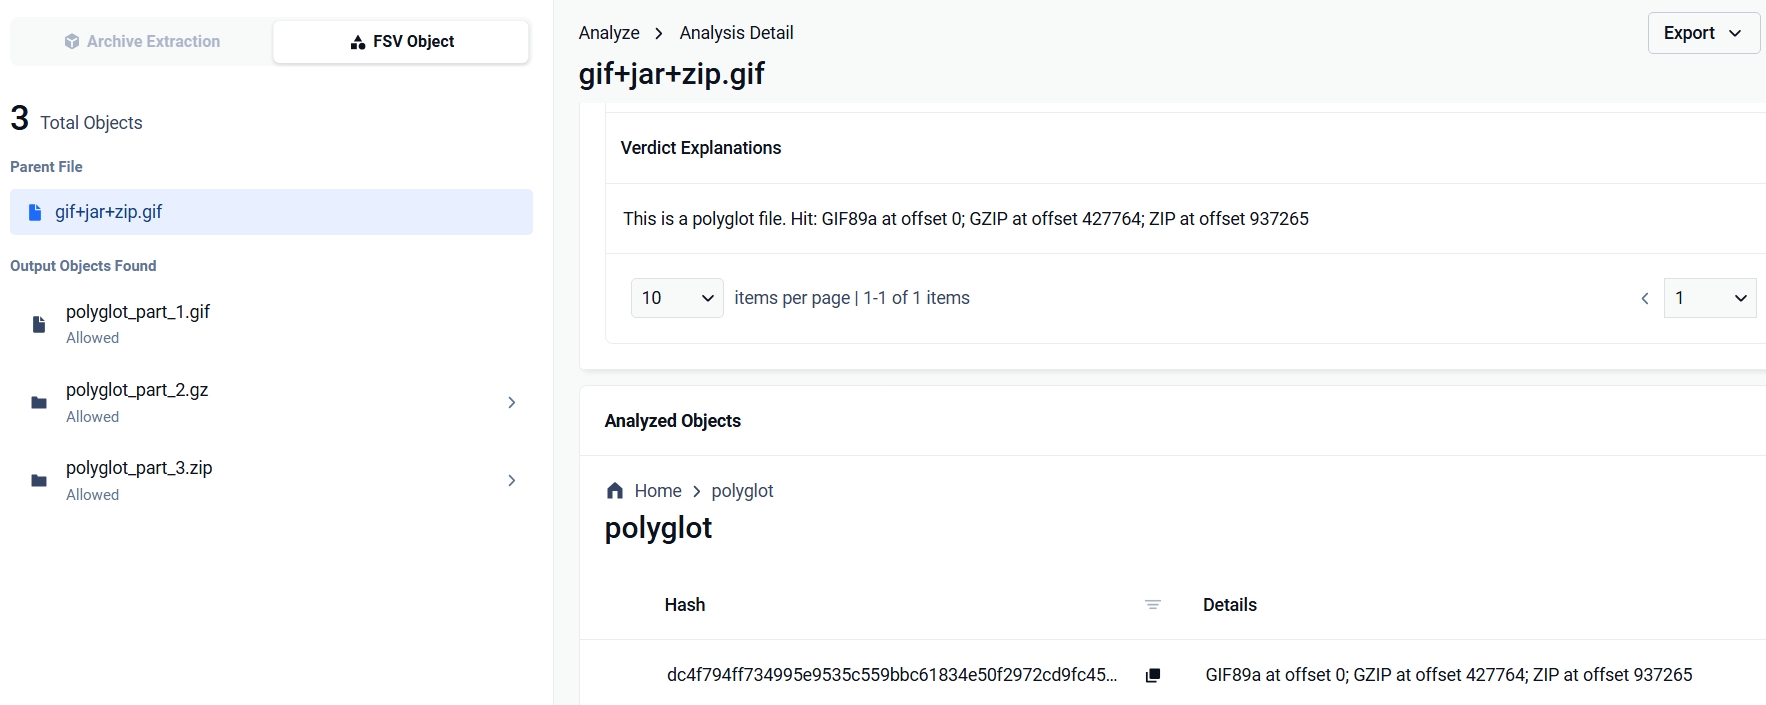
GIF care conține un flux GZIP și o arhivă Java | GIF89a @ 0 · GZIP @ 427.764 · ZIP @ 937.265 | Blocat |
Fișier PDF care conține un fișier JPG și un fișier PNG, la care sunt atașate un fișier ZIP și un fișier TIFF | PDF @ 0 · ZIP @ 204.849 · TIFF @ 257.395 | Blocat; imaginile încorporate nu au fost raportate corect |
Ultimul rând ilustrează modul în care funcționează regula de respingere: verdictul menționează fișierele ZIP și TIFF atașate și ignoră imaginile din interiorul fișierului PDF. Modulul de rezolvare a containerelor le-a considerat ca făcând parte din conținutul propriu al fișierului PDF. Rezultatul JSON al MetaDefender Core™ pentru acel fișier (versiune prescurtată):
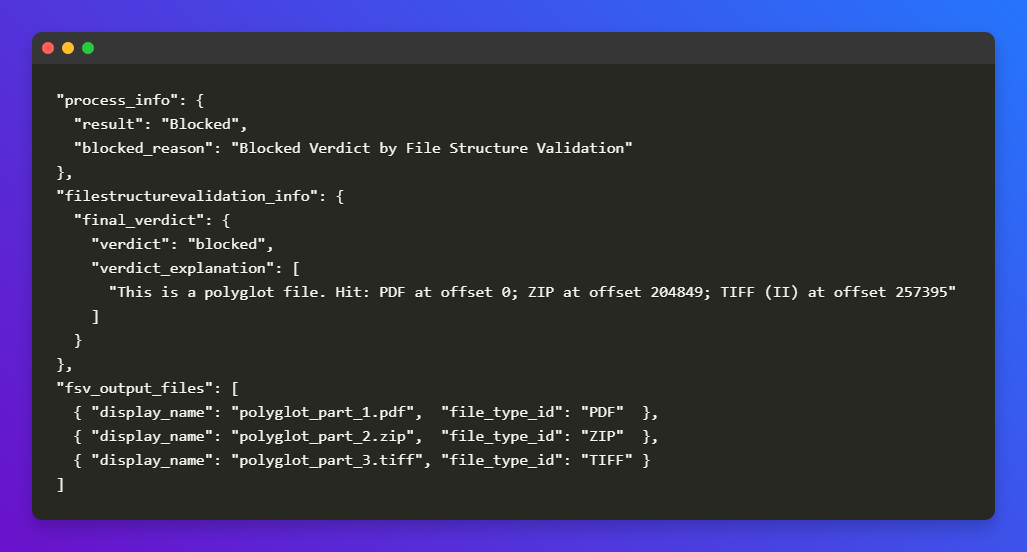
Lista fsv_output_files reprezintă disecția descrisă mai sus, în timp real: cele trei fețe decupate și returnate fluxului de lucru ca obiecte distincte.
Iată capturile de ecran ale fiecărui rezultat de testare din MetaDefender Core™:
Acoperire și configurare
În prezent, acoperirea include formatele pe care atacatorii le combină efectiv: PDF, ZIP, fișiere compuse OLE, PNG, GIF, JPEG, TIFF, RAR, GZIP și 7z.
Rezoluția structurală la sfârșitul containerului se aplică formatelor de container. Funcționalitatea se livrează pe principiul „configurația înainte de toate”: detectarea, blocarea și scanarea completă a fișierelor sunt comutatoare de politici, astfel încât operatorii aleg între vizibilitate și aplicare pentru fiecare implementare.
Concluzia
Un fișier cu două tipuri valide de fațete pune în dificultate orice flux de procesare care îi atribuie un singur tip, iar detectarea unui singur tip stă la baza majorității stivelor de scanare. Detectarea structurală poliglotă acoperă această lacună prin identificarea tuturor fațetelor și demonstrarea faptului că fiecare dintre ele poate fi analizată sintactic. Politica de securitate poate apoi bloca fișierul înainte ca vreo aplicație să aleagă un interpretator greșit.
În prezent, este asigurată detectarea tuturor formatelor comune de atac. Rezolvarea problemelor legate de sfârșitul containerului pentru restul formatelor de arhivă este prevăzută în planul de dezvoltare.
Aflați cum gestionează funcția „Validarea structurii fișierelor” formatele de fișiere care circulă în mediul dumneavoastră.